深度对比GPU服务器三种网络方案InfiniBand、RoCE v2、NVLink的带宽、延迟、成本和适用场景,附AI训练集群网络配置建议。
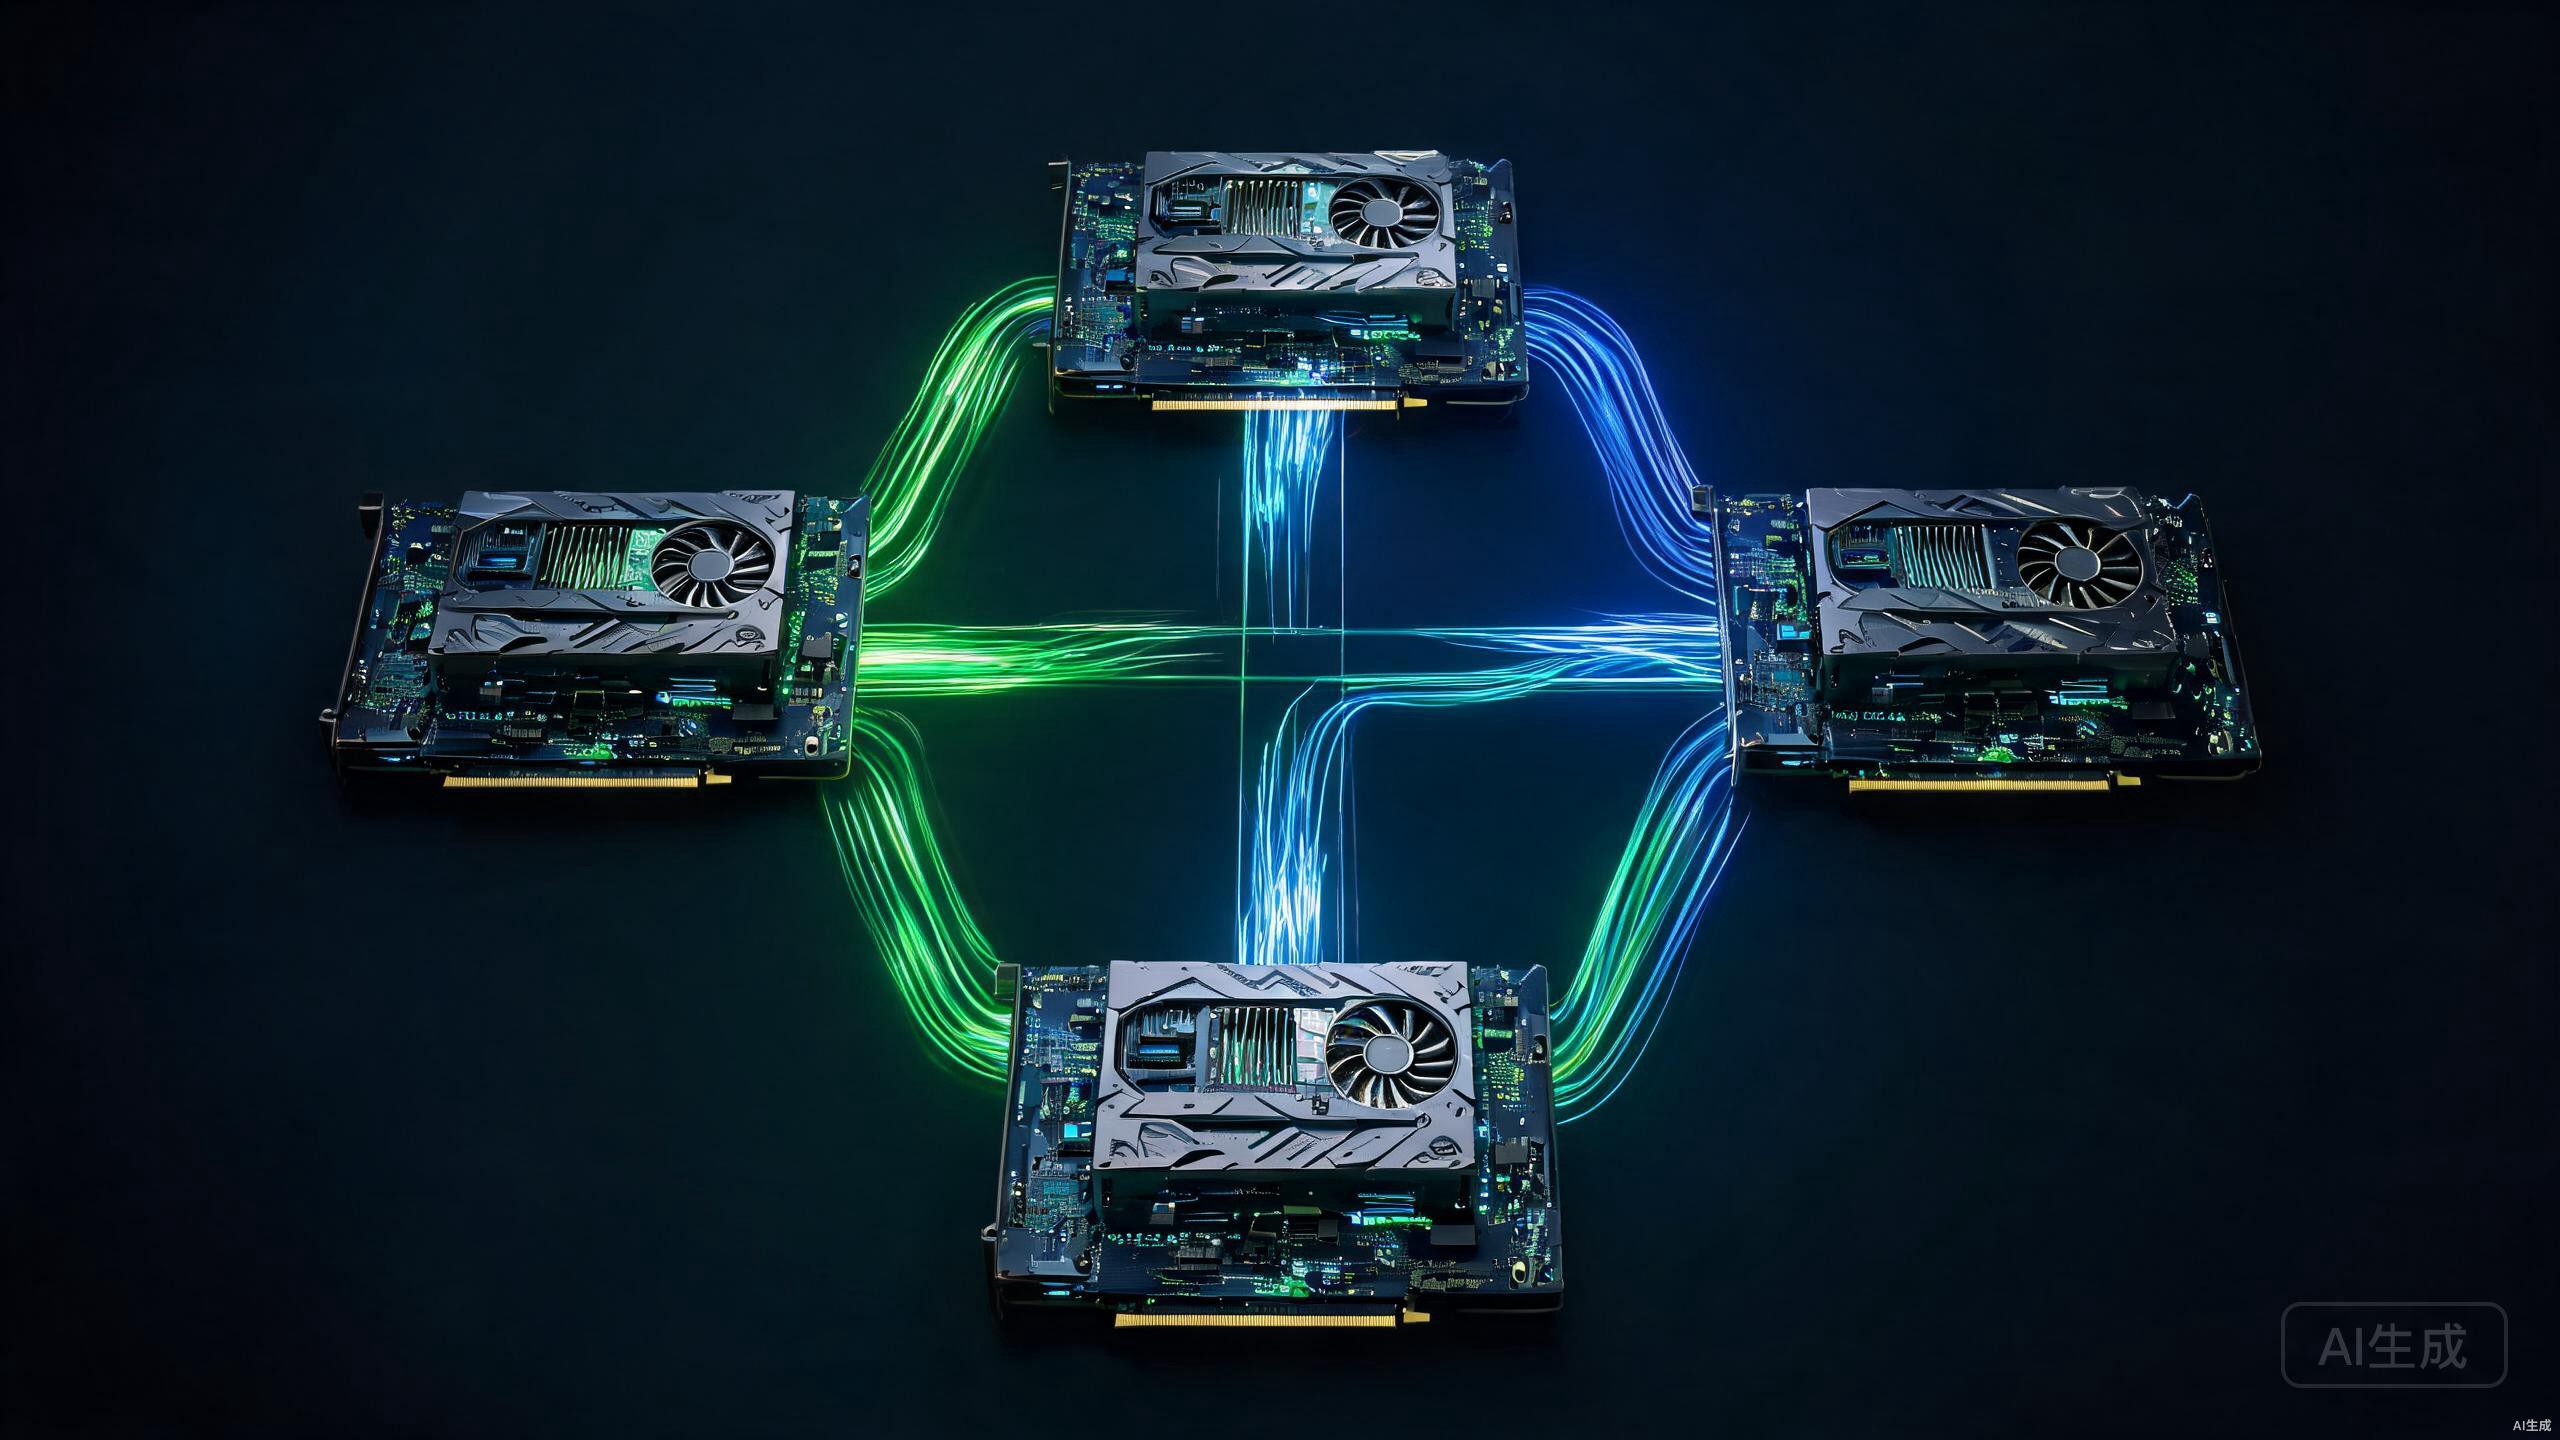
在AI大模型训练中,GPU服务器之间的网络通信是决定训练效率的关键因素。一个175B参数的模型,单次All-Reduce操作需要传输约700GB数据。如果网络带宽不足,GPU大部分时间都在等待数据同步,实际利用率可能不到50%。本文深度对比三种主流GPU互联方案:NVLink、InfiniBand和RoCE v2,帮助您选择最优网络配置。
分布式训练中,多个GPU需要频繁同步梯度数据和模型参数。AllReduce是最核心的通信操作,每个GPU将本地计算的梯度发送给其他GPU并汇总。通信时间与模型参数量成正比,网络带宽直接决定了通信开销。
实测数据显示,8卡A100 PCIe 4.0系统训练BERT-Large时,通信时间占总训练时间的35-45%。而使用NVLink的SXM4系统,通信时间占比仅8-12%。这意味着网络优化可以将训练效率提升2-3倍。
NVLink是NVIDIA专有的GPU高速互联协议,通过直连线缆实现GPU间点对点通信,不经过PCIe总线。
| NVLink版本 | 搭载GPU | 单向带宽 | 双向带宽 |
|---|---|---|---|
| NVLink 3.0 | A100 | 300 GB/s | 600 GB/s |
| NVLink 4.0 | H100 | 450 GB/s | 900 GB/s |
| NVLink 5.0 | Blackwell B200 | 900 GB/s | 1800 GB/s |
NVLink的优势是极低的延迟(<1微秒)和超高带宽,但限制是拓扑范围有限。通过NVSwitch可以在单节点内实现8卡全互联,但跨节点仍需依赖InfiniBand或RoCE。
InfiniBand是Mellanox(现NVIDIA)主导的高性能互联协议,广泛应用于HPC和AI计算中心。
| IB版本 | 带宽 | 交换延迟 | 典型场景 |
|---|---|---|---|
| EDR | 100 Gbps | ~200ns | 中小规模HPC |
| HDR | 200 Gbps | ~200ns | 主流AI训练 |
| NDR | 400 Gbps | ~300ns | 大规模AI集群 |
| XDR | 800 Gbps | ~300ns | 超大规模集群 |
InfiniBand的核心优势是极低的交换延迟(200-300纳秒)和原生RDMA支持,通信效率极高。但成本较高,需要专用的IB交换机和网卡。
RoCE v2(RDMA over Converged Ethernet)允许在标准以太网上实现RDMA通信,无需专用IB设备。RoCE v2通过UDP/IP封装IB传输,可在标准以太网交换机上运行。
RoCE v2的优势是使用标准以太网设备,成本显著低于IB。以太网交换延迟约500-800纳秒,略高于IB的200-300纳秒。但在大规模集群中,以太网可能因拥塞导致延迟波动。
| 对比维度 | NVLink | InfiniBand | RoCE v2 |
|---|---|---|---|
| 最高带宽 | 1800 GB/s(v5) | 400 Gbps(NDR) | 400 Gbps(以太网) |
| 延迟 | <1微秒 | 200-300纳秒 | 500-800纳秒 |
| 适用范围 | 单节点(最多8卡) | 跨节点 | 跨节点 |
| 成本 | GPU附加成本 | 高(专用设备) | 中(标准以太网) |
| 扩展性 | 有限(单节点) | 优秀 | 优秀 |
| 管理复杂度 | 低 | 中 | 高(需调优) |
单节点8卡GPU服务器,GPU间通信走NVLink/NVSwitch即可。不需要额外的IB或RoCE网络,除非需要跨节点通信。
2-4个节点的集群,建议优先选择InfiniBand HDR(200G)。2-4个节点的IB交换机成本约10-20万元,但训练效率比RoCE高15-25%。如果预算有限,RoCE v2配合100G以太网也可以,但需要仔细调优PFC和ECN参数。
大规模集群需要采用Fat-Tree(胖树)拓扑,分为叶子层和脊柱层。每个节点通过2张网卡连接到2个叶子交换机,实现冗余。64卡集群通常需要4-8台NDR 400G交换机。
| 方案 | 64卡集群网络成本 | 训练效率 | 单位成本性能 |
|---|---|---|---|
| NVLink + IB NDR | ~80-120万 | 100%(基准) | 1.0x |
| NVLink + RoCE 200G | ~40-60万 | 80-85% | 1.1x |
| 仅PCIe + RoCE 100G | ~20-30万 | 50-60% | 0.7x |
虽然IB方案成本最高,但训练效率也最高。对于需要长时间训练的大模型项目,IB方案节省的训练时间可以快速回本。一个训练任务如果从30天缩短到24天,节省的电费和人力成本就可能覆盖网络设备差价。
在中小规模集群(<32卡)中,RoCE v2经过良好调优后性能接近IB。但在大规模集群中,IB的低延迟和流量控制优势明显,仍是首选。
可以且推荐。标准做法是节点内用NVLink,节点间用IB或RoCE。NCCL通信库会自动选择最优路径。
IB方案推荐NVIDIA ConnectX-7 HDR/NDR。RoCE方案推荐Mellanox ConnectX-6 Dx或Broadcom NetXtreme。
GPU服务器网络选择需要综合考虑规模、预算和性能需求。8卡单机选NVLink;16-32卡集群优先IB HDR;64卡以上大规模集群选IB NDR+Fat-Tree拓扑。RoCE v2是性价比之选,适合预算有限且愿意投入调优工作的团队。无论选择哪种方案,节点内NVLink都是标配,确保GPU间通信效率最大化。
同样的显卡,换个推理框架,吞吐量可能差好几倍。本文对比 vLLM、SGLang、TensorRT-LLM 三大主流大模型推理框架的定位与适用场景,讲清连续批处理、PagedAttention、前缀缓存等关键技术对硬件的要求,给出选型判断标准与部署时该关注的显存、并发与延迟指标。
企业想把内部文档做成能问答的知识库,RAG(检索增强生成)是最落地的路线。本文拆清 RAG 系统的三段算力——文档解析入库、向量检索、大模型推理,分别说明向量数据库、推理显卡、内存与存储该怎么配,给出单机与分离部署两种方案,并按预算分三档给出配置参考,帮 IT 负责人一次配到位。
企业想把大模型部署在自己内网,硬件到底要怎么配?本文讲清私有化部署的三条路径,说明显存是硬门槛并给出常见模型规模与显存的对应关系,再拆解CPU、内存、存储、网络与多卡互联的配置要点,区分推理与训练的配置差异,附分档预算方案与常见误区,帮企业把钱花在真正的瓶颈上。
AI大模型一体机这两年很火,但它并不适合所有企业。本文讲清一体机的本质是软硬一体的交付形态,与自建GPU服务器在交付方式、软硬件栈、运维责任、合规能力、扩展性与成本六个维度的真实差异,说明一体机真正适合哪些企业,并给出选型必须盯死的参数与合同条款,帮企业判断该买一体机还是自己配GPU服务器。
把需求告诉我们,工程师直接出方案和报价,不绕弯子。
留个电话就行,配置想法可以之后聊
