预算摆在桌上,选卡犯难:一张 RTX 4090 一万多,一张 A100 六七万起,一张 H100 要二十万以上,差价十倍以上,性能真的差十倍吗?我的业务到底该买消费卡还是专业卡?这是 AI 算力采购中被问得最多的问题。这篇文章从架构、显存、互联、软件生态和真实业务场景五个维度,把消费级卡与专业卡的差异讲透,帮您把钱花在刀刃上。
一、先看底子:三条产品线的定位差异
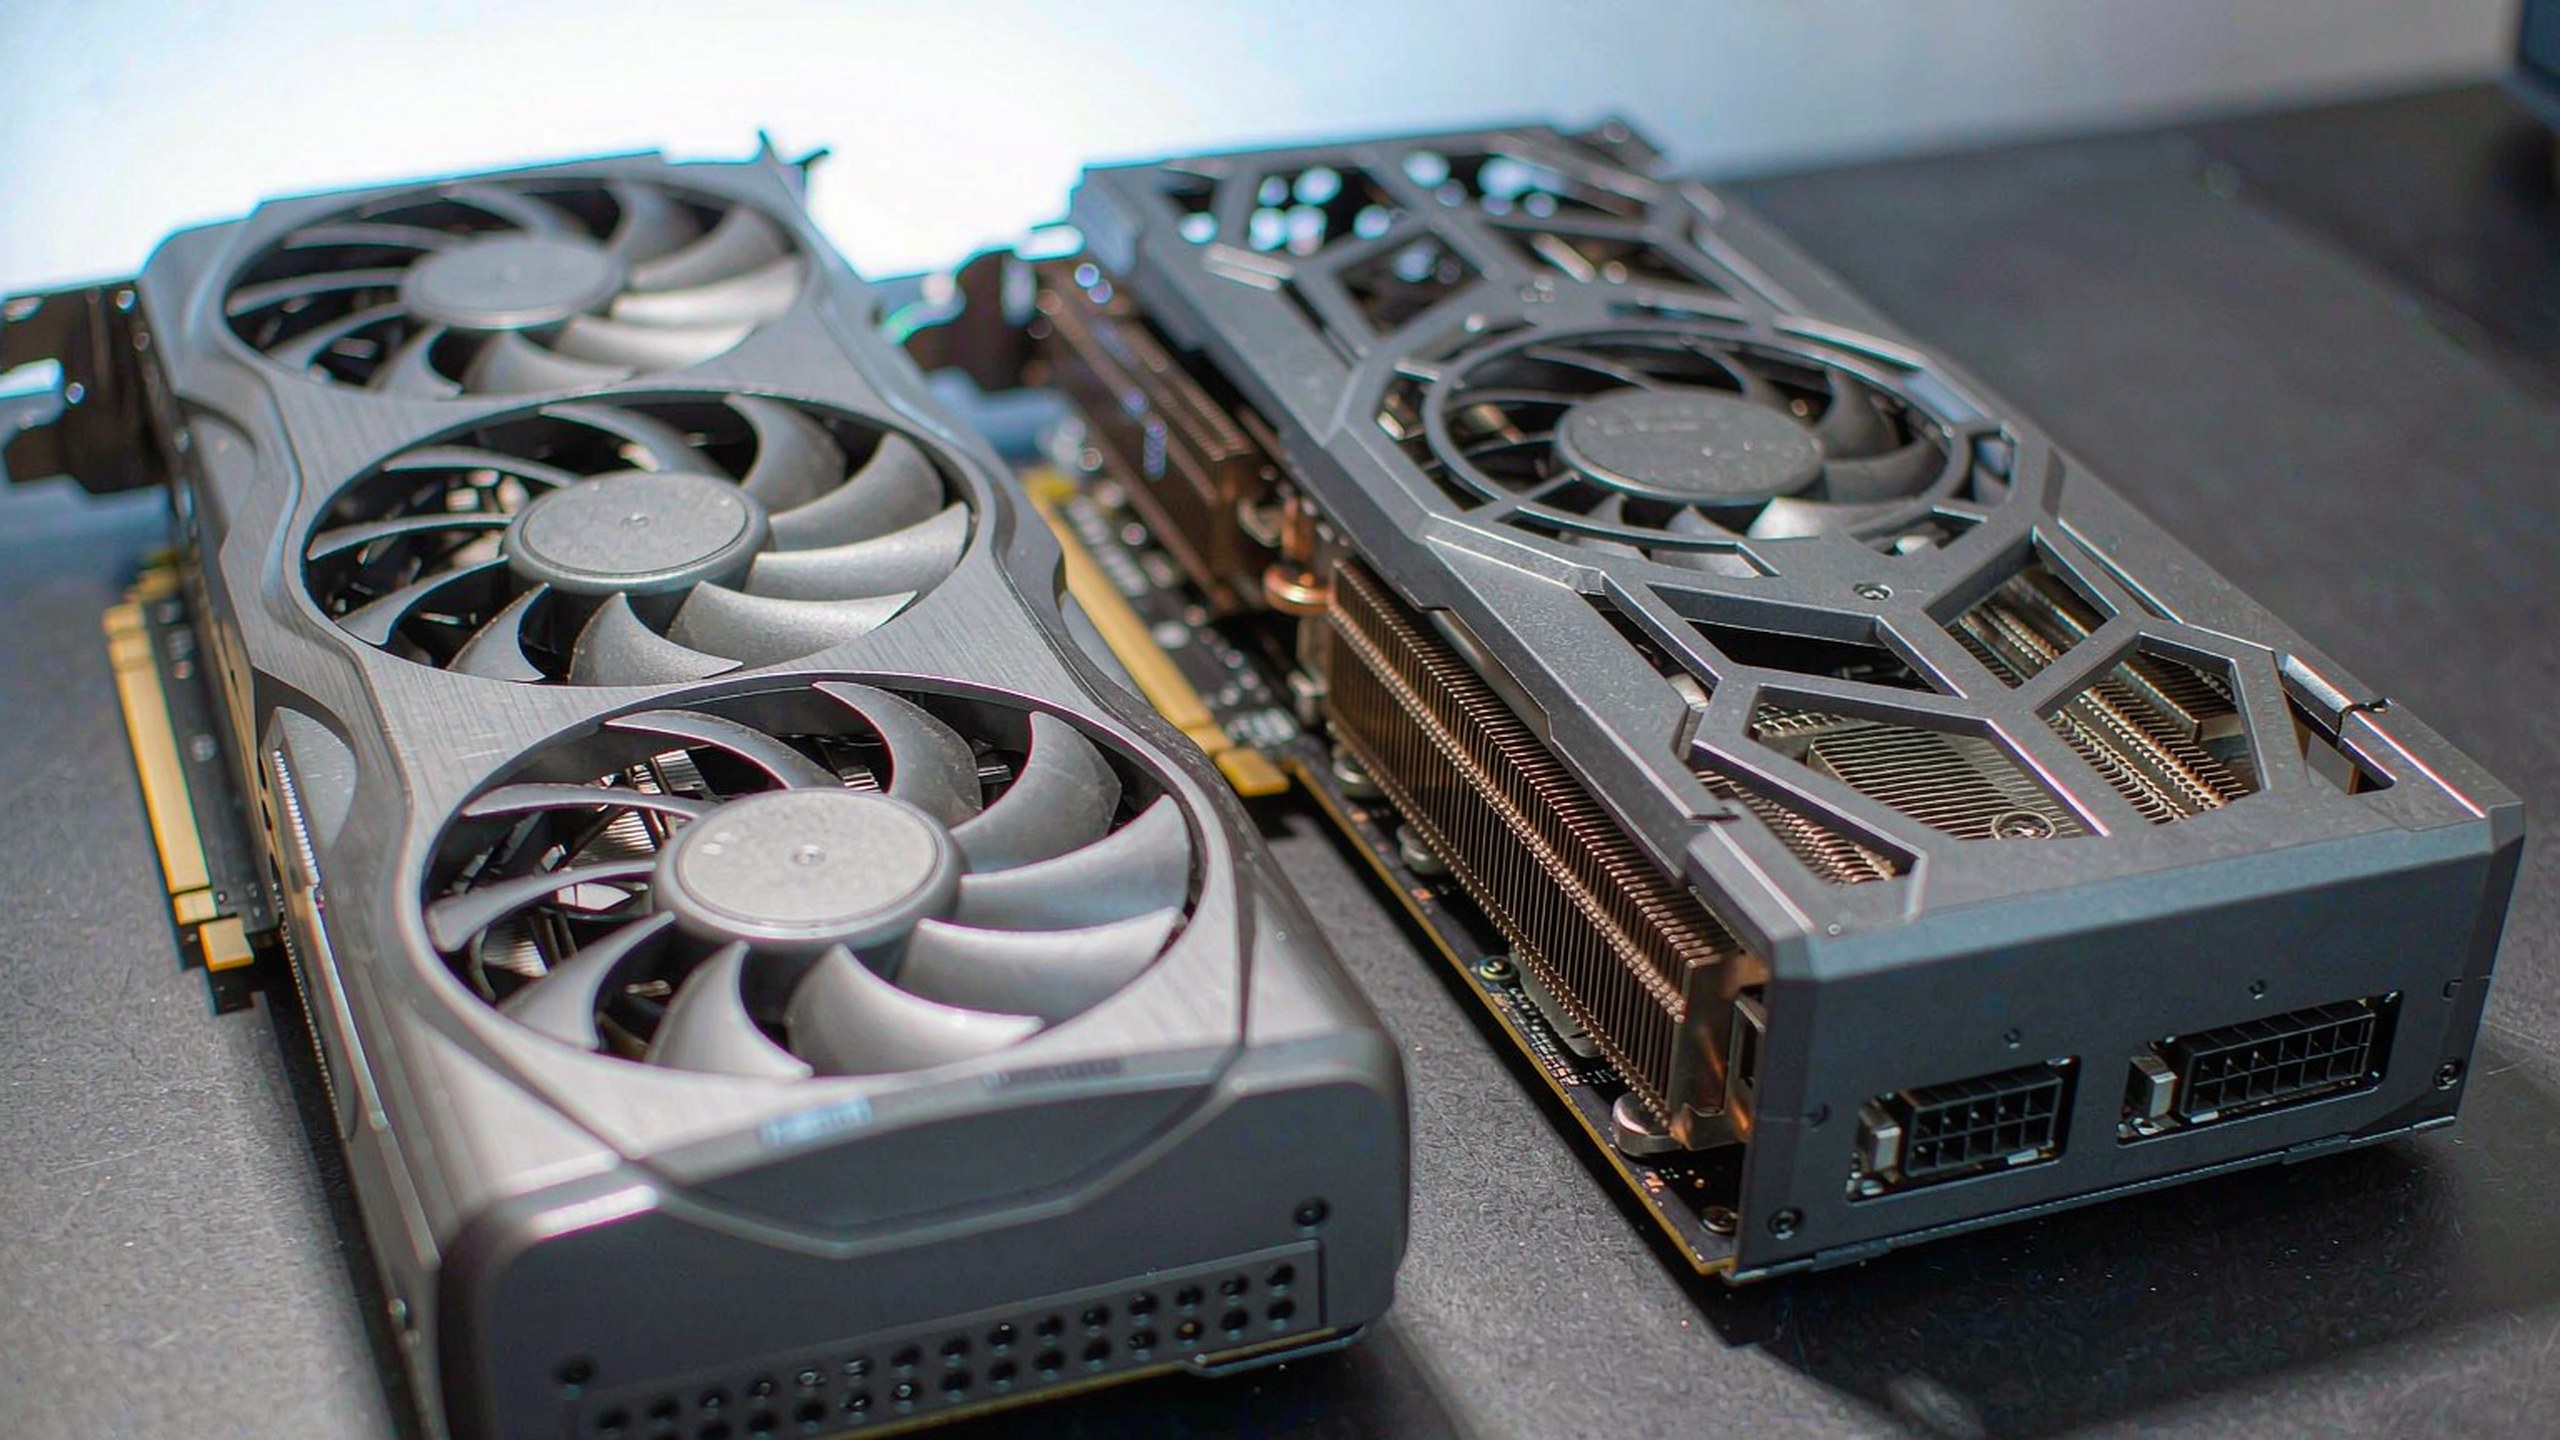
NVIDIA 的产品线分工明确。RTX 4090 属于 GeForce 消费级系列,为游戏和内容创作设计,24GB GDDR6X 显存、单卡功耗 450 瓦,是消费级的天花板。A100 属于数据中心专业计算卡,基于 Ampere 架构,提供 40GB 与 80GB 两个显存版本,搭配 HBM2e 高带宽显存,支持多卡 NVLink 互联。H100 是 A100 的继任者,基于 Hopper 架构,加入了专为大模型 Transformer 结构设计的 Transformer Engine,在训练百亿、千亿参数模型时有明显优势。一句话概括定位:4090 是全能型选手里的性价比之选,A100 和 H100 是为大规模训练和多卡集群而生的专业选手。
二、显存与带宽:决定模型规模的第一道门槛
显存容量决定能装下多大的模型,显存带宽决定数据喂进计算核心的速度。4090 的 24GB GDDR6X 显存带宽约 1TB/s;A100 80GB 的 HBM2e 带宽约 2TB/s;H100 SXM 版带宽约 3.35TB/s。这意味着处理大模型推理时,A100、H100 能一口气装下更大的模型、以更快速度读取权重,而 4090 需要靠量化压缩或多卡分摊来弥补容量差距。实际体验上,跑 70B 量化模型的推理,多卡 4090 可以完成,但单次请求的响应时间通常会长于同等规模的 A100 方案;如果是并发量大的生产服务,专业卡的体验优势会进一步放大。
三、多卡互联:训练场景下最关键的分水岭
如果说推理还能靠量化和小模型绕开硬件差距,训练就是实打实的硬仗。A100、H100 支持 NVLink 高速互联,卡间带宽可达数百 GB/s,多卡协作训练时梯度交换几乎不构成瓶颈;4090 没有 NVLink,多卡之间只能走 PCIe 通道,PCIe 4.0 x16 的理论带宽约 32GB/s,实测有效带宽差距在一个数量级。做大规模分布式训练时,4090 集群会有相当比例的时间浪费在等待数据同步上,训练效率随卡数增加衰减明显:两卡时尚可接受,到四卡以上,线性加速比就明显劣于专业卡。所以业内的普遍共识是:四卡以下做推理和轻量微调,4090 经济性突出;八卡以上做严肃训练,专业卡集群是更合理的选择。
四、软件生态与驱动授权:容易被忽略的两件事
专业卡对 vGPU、虚拟化、ECC 显存校验等企业级特性有完整支持,7×24 小时高负载运行的稳定性也是按数据中心标准设计的。而 GeForce 驱动的最终用户协议对数据中心环境中的商业部署存在限制条款,把大量 4090 放进 IDC 机房对外提供算力服务,授权合规上需要谨慎评估;在自己办公室、实验室场景做研发使用一般没有问题。另外 H100 还有面向中国市场的合规版本问题,不同版本的算力和互联规格有差异,采购时务必确认供应版本的具体规格,让供应商在合同里写明,避免货不对板。
五、价格与算力成本:算一笔真实的单价账
以近期市场行情做参考(价格波动较大,以实时报价为准):4090 单卡一万到两万元区间;A100 80GB 单卡市场价在十万元以上,H100 则更高,且供货紧张。按单位显存的采购成本算,4090 反而是三者中最低的;但按训练吞吐量算,多卡 A100 集群凭借 NVLink 和高带宽显存,单位有效算力的成本会随规模摊薄。还有一个常被忽略的持有成本:4090 单卡 450 瓦,多卡整机的电费和散热投入不低,长期运行的电费账要提前算,可参考我们的服务器功耗电费计算文章。
六、场景对号入座:五类需求的最优解
价格之外,供货渠道的差异也要纳入考量。4090 渠道相对多元,本地现货普遍好找,从下单到部署可以按天计;专业卡的供货节奏受厂商配额影响,热门型号排队等货以周甚至月计,项目时间紧的情况下,「有货」本身就是重要的选型权重。另外专业卡的二手与库存渠道比消费卡更不透明,非原厂渠道采购时验货环节要格外严格。
第一类,学习研究、跑开源小模型、做毕业设计:单卡 4090 足够,预算敏感时的首选。第二类,企业内部知识库、客服机器人等推理业务:并发不高用 4090 单卡或双卡;并发大、响应要求高,考虑 A100。第三类,LoRA 微调、行业模型定制:数据量和模型规模不大时 4090 可胜任,长期高频微调建议 A100 级别。第四类,从零训练或大参数全参微调:直接上 A100/H100 多卡集群,不必犹豫。第五类,对外提供算力服务或大规模生产推理:专业卡在稳定性、授权、虚拟化支持上都更合适。拿不准时,把模型名称、参数量、并发量告诉供应商,让对方出配置建议再比价,这比自己在参数表里纠结高效得多。
补充一个容易被忽略的维度:装机形态对两类卡的要求也不同。4090 消费卡用普通塔式机箱或高密度工作站机箱即可承载,散热风道按桌面标准设计;专业卡多为被动散热设计,必须装在服务器机箱里靠机箱风扇强制风冷,对机箱、导风罩和机房环境温度都有明确要求。因此选了专业卡,机箱、机房散热投入也要同步规划,否则卡的性能发挥不出来。
实践中还有一种被验证有效的省钱路线值得单独展开:消费卡加专业卡的组合拳。很多团队把 80% 的日常负载——模型调试、小批量推理、日常实验——放在 4090 集群上,把 20% 的重训练任务安排在按需租用的 A100 资源上完成,整体算力支出能压缩相当比例。这条路线的关键是分清负载性质:训练怕通信瓶颈,推理怕显存不够,各自的瓶颈不同,配置思路也就不同。决定自购还是租用专业卡,可以用「预计连续使用时长是否超过一年」做粗判,更细的测算方法可参考我们的租购回本分析文章。如果您想了解 4090 整机的具体配置和价格,也可以参考此前的 4090 AI 服务器搭建文章,那里有单卡到四卡的完整方案。
七、结语:没有最好的卡,只有匹配业务的卡
回到开头的问题:4090 和 A100、H100 差在哪?差在显存容量、带宽、多卡互联和企业级能力,差距确实存在,但不是所有业务都需要为这些差距买单。决策的核心永远是您的模型规模、并发要求和业务阶段,而不是追顶尖配置。从验证到上线,分阶段匹配算力,才是成熟团队的做法。如果您在北京,需要 4090 或专业卡服务器的选型建议与整机报价,今朝恒业提供按场景定制的算力方案,原厂授权渠道供货,欢迎咨询对比。
延伸阅读:RTX 4090能做AI服务器吗?中小企业配置与价格、GPU服务器报价与成本分析:8卡A100/H100多少钱?、H200和B200有什么区别?AI服务器GPU怎么选、GPU服务器散热方案:8卡服务器液冷vs风冷实测、服务器功耗与电费计算:一年电费多少钱?。
常见问题
两张 4090 能顶一张 A100 吗?
纯算力数字上大致相当,但实际不是:4090 缺 NVLink,多卡协作训练时通信开销大,训练效率明显低于 A100;做单卡能装下的推理任务时,两张 4090 反而比一张 A100 更划算,关键看业务类型。
H100 比 A100 强多少,值不值差价?
在千亿参数大模型训练场景,H100 凭 Transformer Engine 和更高带宽通常有几倍于 A100 的效率提升;但如果只是推理或中小模型训练,A100 甚至 4090 的性价比更高,值不值取决于模型规模。
你们能提供专业卡服务器的整机配置方案吗?
可以。我们 2001 年成立至今服务 300 多家企业客户,可按您的模型与并发需求出整机配置与报价,原厂授权渠道供货,北京支持上门安装部署,欢迎咨询。