一、磁盘用到多少算危险
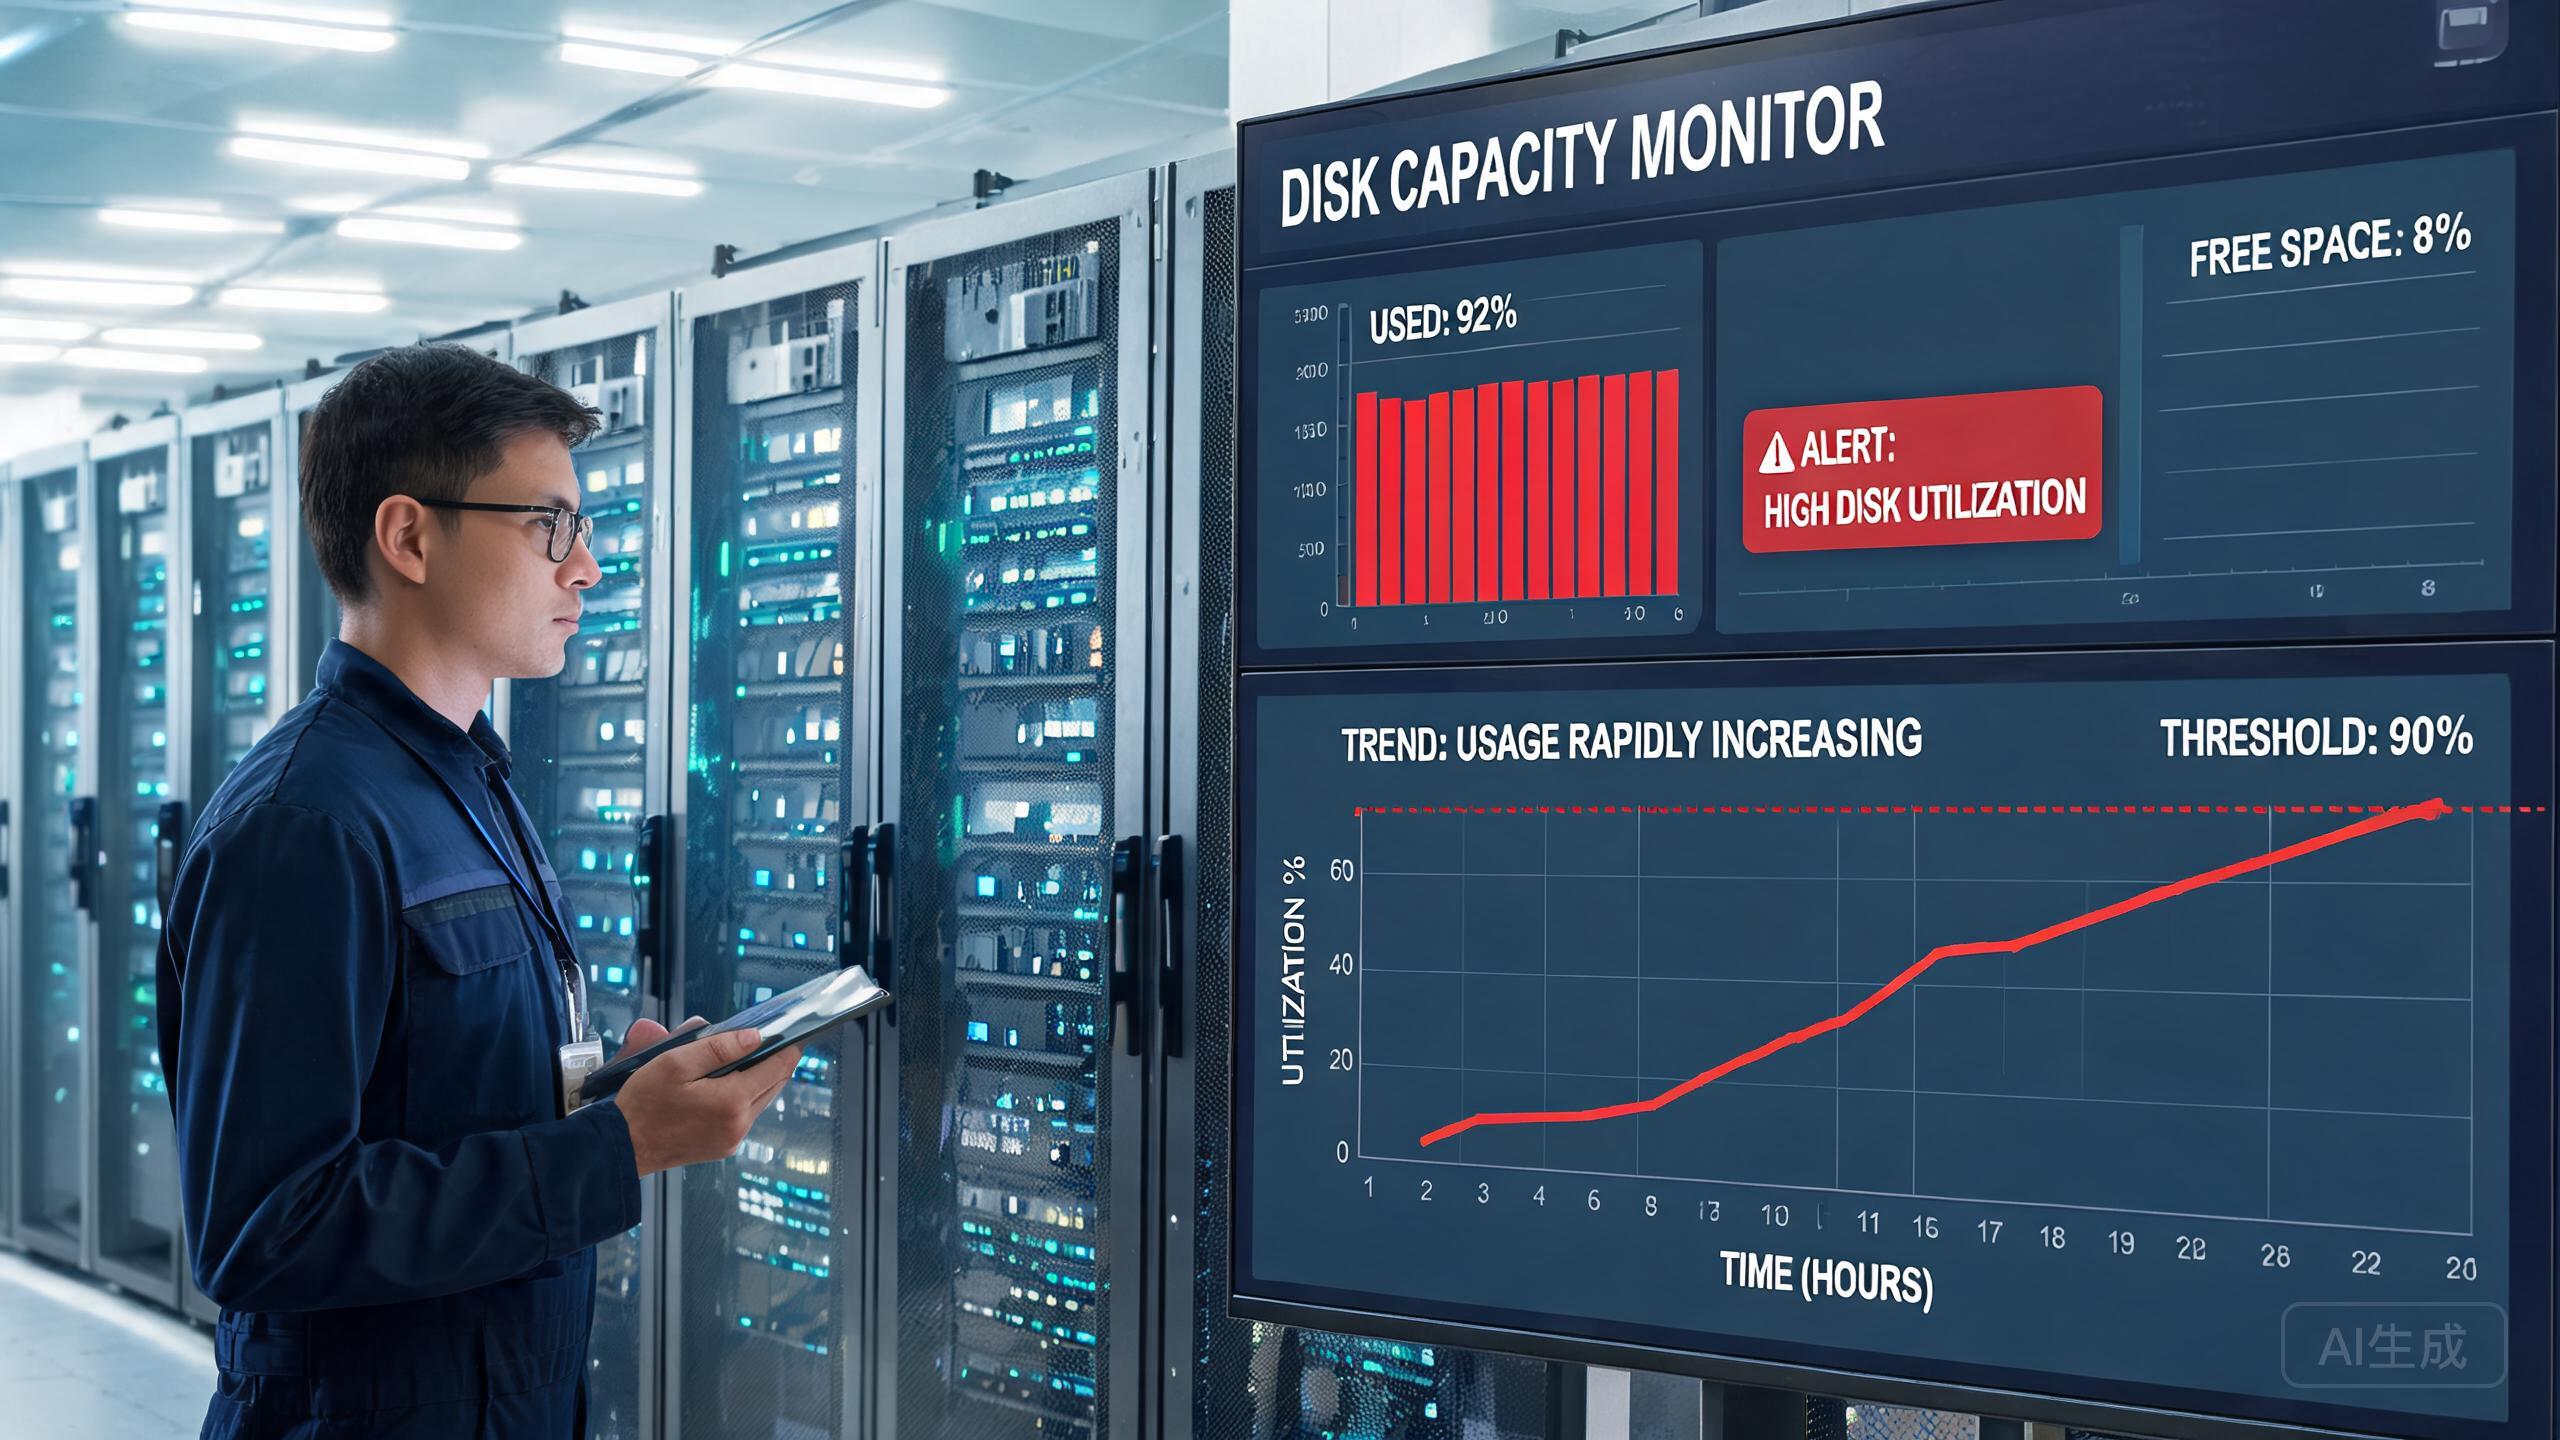
没有绝对的栏线,要看业务类型和文件系统,但有一个通用警戒线:
| 使用率 | 状态 | 建议动作 |
|---|---|---|
| 0-60% | 健康 | 定期看看即可 |
| 60-80% | 留意 | 关注增长趋势,准备扩容 |
| 80-90% | 预警 | 尽快扩容或清理,风险升高 |
| 90%以上 | 危险 | 可能写不进去、服务异常,立即处理 |
一旦接近90%,数据库、日志、临时文件都可能写不动,服务随时宕机。所以真正该做的是在达到危险线之前预警,而不是等满了再救火。如何避免磁盘爆满的常见坑,可参考服务器磁盘空间不足怎么清理。
二、怎么查看当前剩余空间
先会看,再谈监控:
- Linux:
df -h查看文件系统使用率,du -sh /*定位大目录; - Windows:资源管理器的磁盘属性,或
Get-PSDrive/fsutil; - 监控工具:用Zabbix/Prometheus采集磁盘使用量并告警,见Zabbix/Prometheus服务器监控部署。
很多"磁盘满了"其实是某一个分区/挂载点满了,df -h 每一行都要看全。查看配置的基础命令还可以参考Linux/Windows配置查询命令大全。
三、空间告急时的应急处理
真到了90%以上,先解燃眉之急:
- 清理日志和临时文件:日志、缓存、临时目录往往是元凶,清理见磁盘爆满清理指南;
- 暂停非核心写入任务:给系统喘息;
- 归档冷数据:把不常用的数据移到备份或对象存储;
- 扩容或加盘:这才是长期解。
注意清理前先确认哪些可以删,数据库文件和备份别乱动,否则数据丢失追悔莫及。想彻底把存储规划好,见下一节。
四、怎么规划扩容:加盘、JBOD还是换大硬盘
空间不够了,扩容方式有三种:
| 方式 | 适用 | 要点 |
|---|---|---|
| 加盘扩RAID | 阵列有空槽 | 同规格扩,扩容对RAID5/6友好 |
| 外接/内置存储 | 无空槽 | 走JBOD/NAS/SAN,见下文 |
| 换大容量盘 | 旧盘小 | 适合单独存储池/单盘场景 |
如果是历史数据多、想平滑扩张,可考虑存储架构。搭一套可横向扩展的存储方案,参考2U服务器存储扩展:JBOD vs NAS vs SAN。到底该加盘还是换整机,还要看服务器本身扩展能力,见2U服务器能装几块硬盘。
五、RAID与冗余:扩容时别忘的一笔账
扩容时必须把RAID冗余算进可用容量,别只看物理盘总数:
- RAID1镜像:可用容量≈总容量一半;
- RAID5:可用容量≈总容量减一块盘;
- RAID6:可用容量≈总容量减两块盘;
- RAID10:可用容量≈总容量一半。
同样4块4T盘,RAID5约12T可用,RAID10只有8T,差别很大。想搞懂不同RAID级别到底剩多少可用空间,可读服务器RAID详解和RAID级别选择完全指南。
六、容量监控的自动化建议
别靠人肉盯df,整一套告警才是正经:
- 在Zabbix/Prometheus里对使用率>80%设置告警;
- 对关键盘做增长趋势预测,提前预警;
- 把日志、备份、临时目录分离,避免一个目录拖垮整机;
- 定期检查坏道与SMART,别等盘坏了才发现空间也没了,见硬盘故障排查与数据恢复指南。
磁盘容量管理和硬盘健康是一体的:空间快满、盘又在退化,是最危险组合。想从选型端就把存储规划抓好,可看SAN vs NAS vs DAS怎么选。
七、常见误区
- 只看物理容量不看可用容量:RAID消耗不容忽视;
- 不设预警,等满了再救:满盘几乎是宕机前兆;
- 扩容不看RAID:乱加盘可能破坏现有阵列;
- 清理不清日志:日志不轮转,很快又满。
把"预警+自动告警+定期清理+按需扩容"四个动作加起来,服务器存储才算健康。选配存储时用合适接口的硬盘能省心不少,选型参考服务器硬盘怎么选:SAS/SATA/SSD/NVMe。
八、结语
服务器硬盘容量管理的关键是:把80%当预警线、90%当危险线,用zf/vm监控工具自动告警,及时清理日志和冷数据,按RAID冗余算出真实可用容量再规划扩容。把存储空间管好,就能避免"数据中心还在、业务先躺了"的尴尬。
延伸阅读推荐: