曙光AI服务器怎么选,是很多准备上AI项目企业的第一道门槛。同样是机架式服务器,AI机型在GPU承载、供电、散热和扩展设计上完全是另一套逻辑,普通服务器加张显卡很难替代。本文围绕曙光(中科曙光)AI服务器,从GPU选型、CPU与内存配比、存储网络到散热供电,把配置要点和场景匹配一次讲清,帮你在采购前把方案定下来。
一、曙光AI服务器和通用服务器差在哪
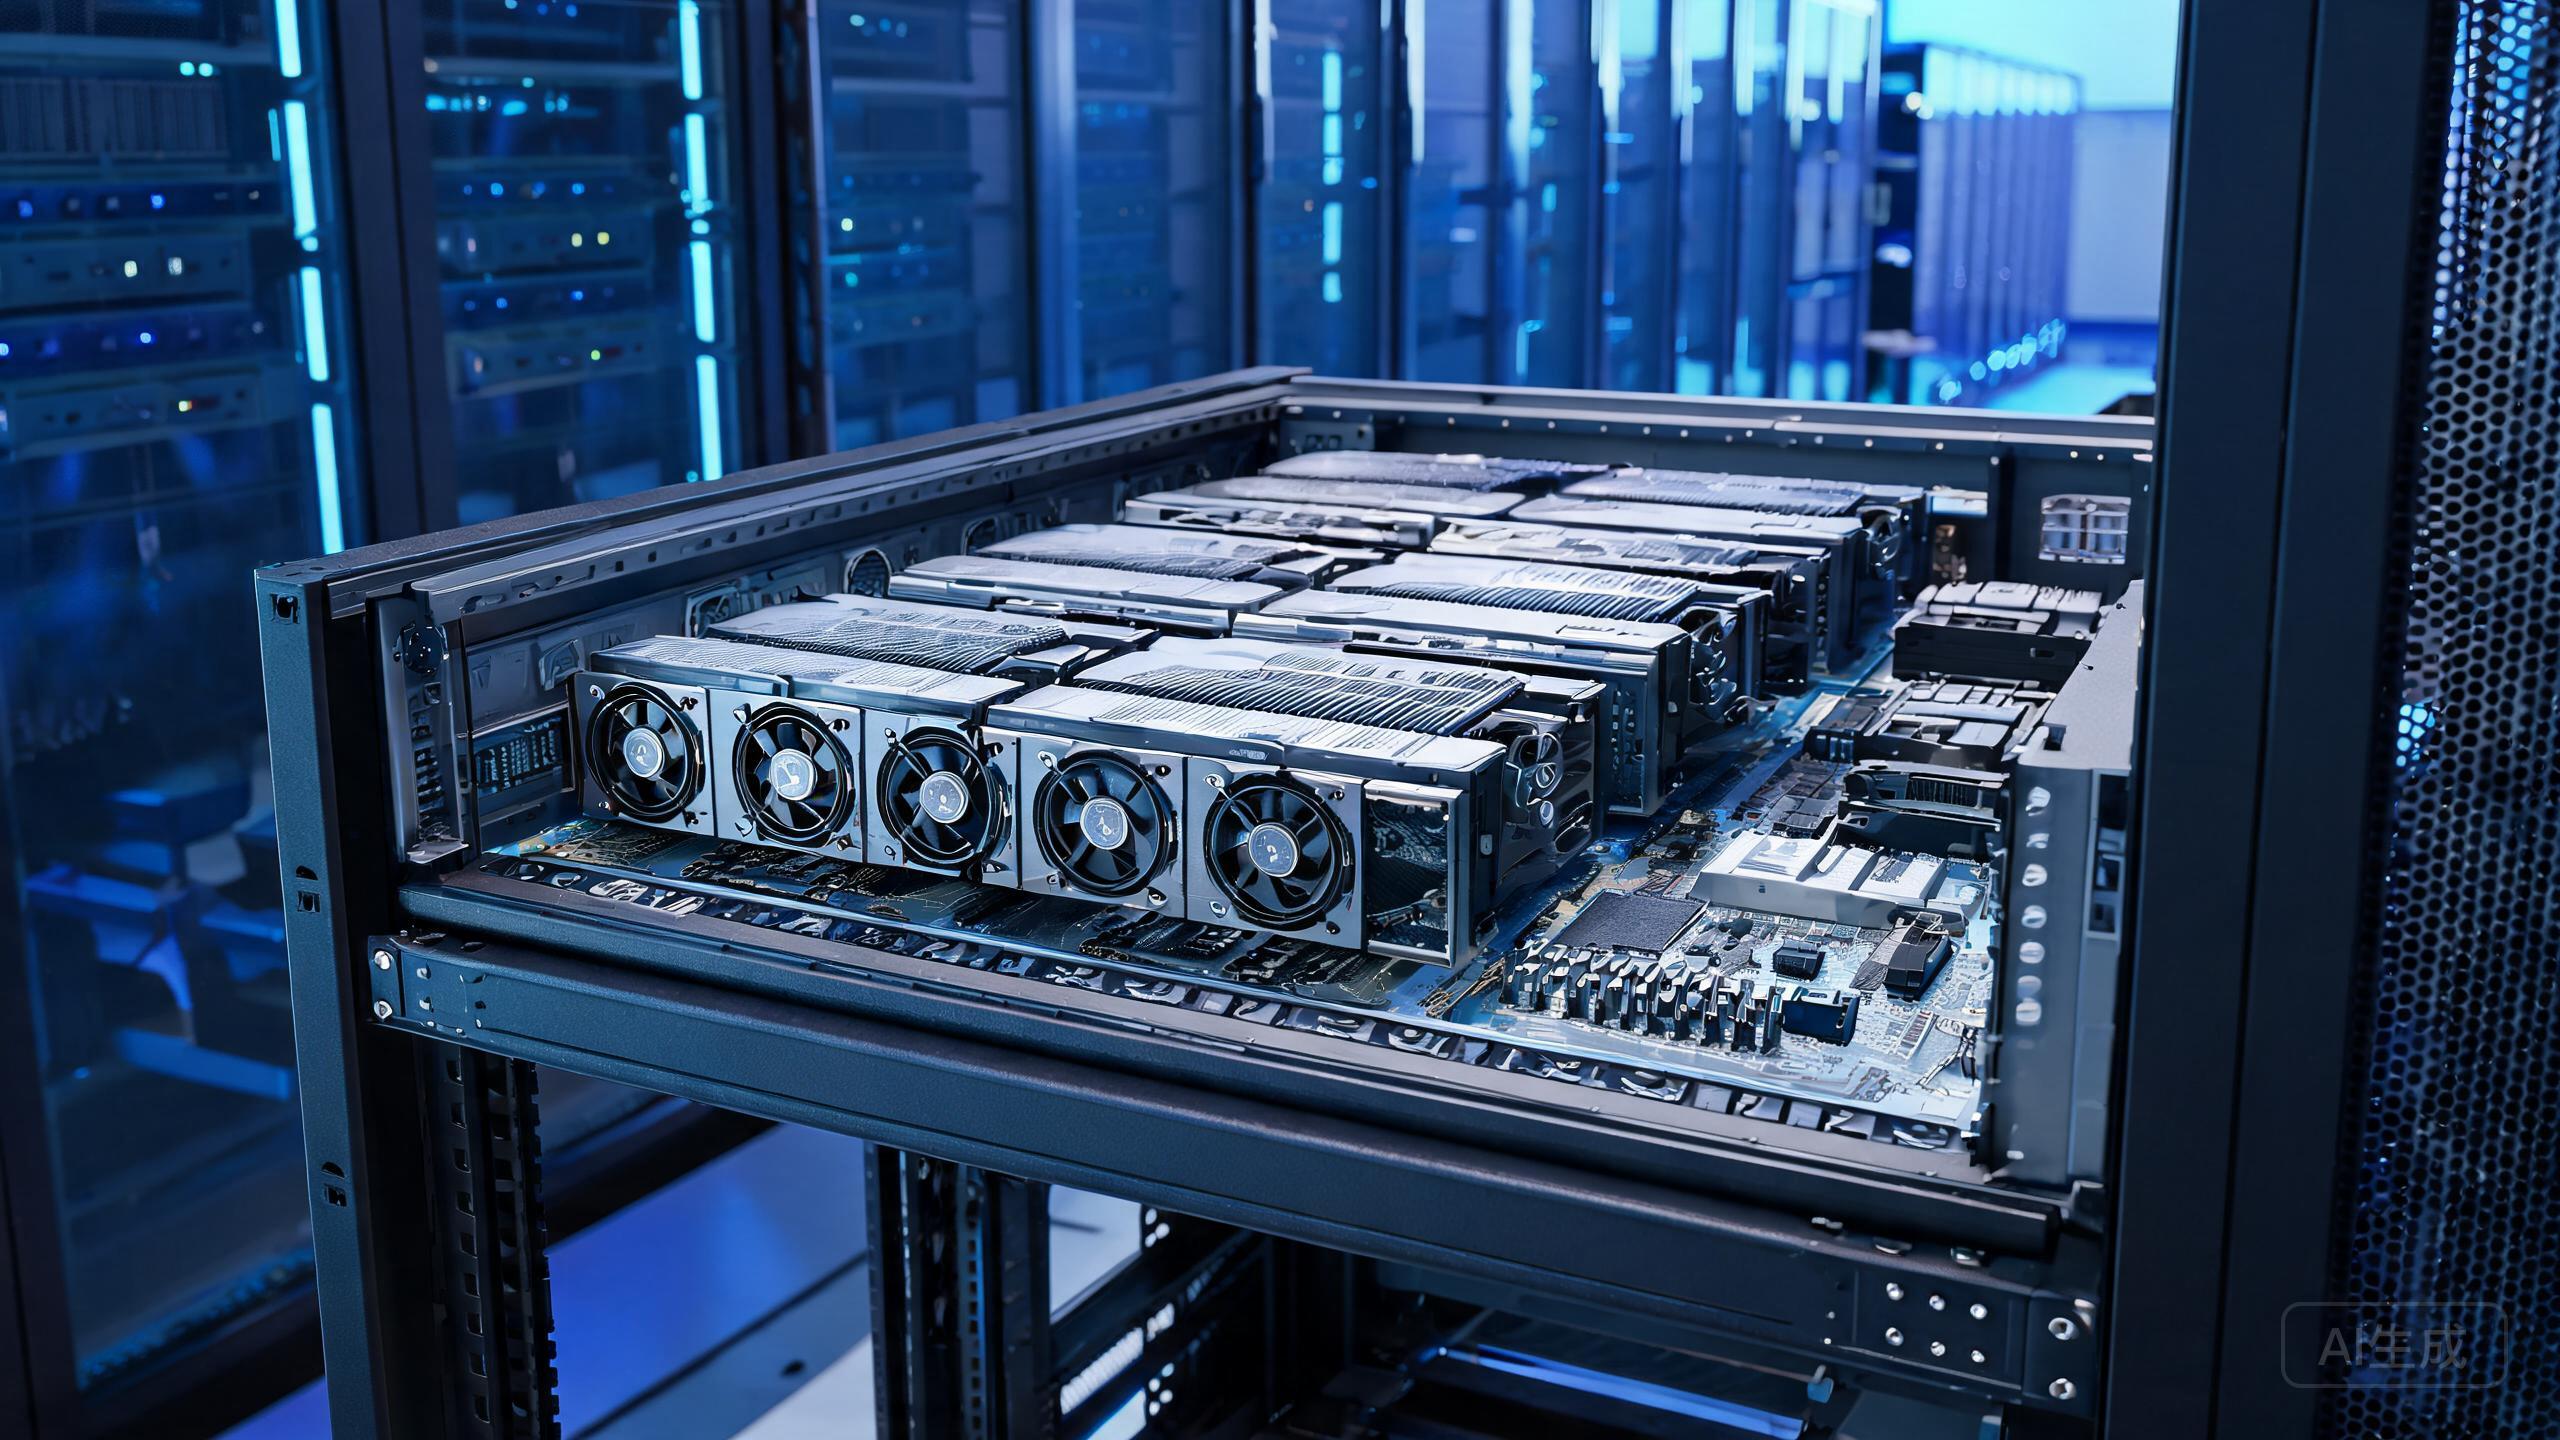
通用服务器主要跑数据库、虚拟化和业务系统,看重的是CPU核数、内存容量和存储可靠性;AI服务器则围绕GPU这类加速卡来设计,机箱更厚、风道更强、供电更猛,主板上的PCIe通道和盘位布局也完全为多卡并行让路。曙光这类AI服务器普遍采用4U机箱、冗余电源和分区散热,能稳定承载多张高功耗加速卡,这是普通2U服务器靠加装显卡难以达到的。也正因为设计重心不同,同样预算下AI服务器在CPU核数上往往不如同价位的通用服务器,这是面向加速场景的取舍,并非配置缩水。简单说,通用服务器拼的是综合能力,AI服务器要的是把算力卡喂饱,并保证长时间满载运行不掉速。
二、GPU怎么选:A系列、H系列与国产算力卡
GPU是AI服务器里最贵的部件,选型直接决定预算和能跑多大的模型。常见路线有三类:一是NVIDIA的A系列,例如A100、A800,生态成熟、框架兼容性好,适合大多数训练和推理项目;二是H系列,例如H100、H800,显存容量和带宽更高,适合大模型训练、多卡互联要求高的场景;三是国产算力卡,例如华为昇腾、海光DCU等,在信创合规项目中更受青睐,价格和供货相对可控。
选卡时先明确模型规模和并发量,再看单卡显存、卡间互联方式和整机可扩容的卡数,不要一上来只盯着绝对算力数字。显存装不下模型,算力再高也用不上;互联带宽跟不上,多卡效率会明显打折。如果项目涉及国产化替代,还要提前确认推理框架和算子库的适配情况,避免选完卡才发现软件生态不匹配。建议把实际业务先跑一轮再定卡,别为了参数好看而多花预算。
三、CPU与内存配比:别让算力卡饿着
很多人选AI服务器只盯着GPU,结果CPU和内存成了瓶颈。训练时CPU要负责数据预处理、给GPU喂数据,核数太少会让GPU频繁等待,利用率上不去;推理时CPU要处理请求调度和前后处理,同样不能太弱。经验做法是双路主流服务器CPU搭配8卡机型,CPU与GPU之间留出余量,避免一边忙一边闲,必要时可按业务类型适当加大核数。
内存方面,一般按每张GPU配到一定比例的系统内存来估算,8卡训练机常见配到512GB以上,显卡显存越大、数据吞吐越高,对系统内存的需求也越大。内存通道要插满以发挥带宽,选购时优先选企业级ECC内存,保证长时间运行的稳定性。内存配置不足会直接影响训练吞吐,具体配比需要结合模型和框架实测调整,不能只按经验拍脑袋,也留出后续扩容的插槽余量。
四、存储与网络:NVMe、IB与100G
AI训练动辄要读写几百GB甚至上TB的数据集,存储带宽跟不上,再强的GPU也只能干等。系统盘建议用企业级NVMe SSD,数据盘根据预算选择大容量NVMe或高性能SAS、SSD组合,保证顺序读带宽和随机读性能。对于需要频繁加载小文件的场景,NVMe的低延迟优势更明显,能减少训练等待时间。容量规划要按数据集规模留出冗余,避免训练中途因空间不足被迫中断。
网络方面,单机多卡靠PCIe或NVLink互联,多机训练则依赖高速网络。InfiniBand延迟低、带宽高,是训练集群的常见选择;预算有限时,100G以太网配合RoCE也能满足多数场景。做推理或小规模训练的单机,千兆到万兆网卡通常够用,但一旦涉及多机协同,网络一定不能省,否则会拖累整体效率,切换网络方案前最好先做小规模联调测试。
五、训练场景与推理场景的机型匹配
训练和推理对硬件的诉求并不一样,配置思路要分开。训练场景追求高算力、高显存带宽和卡间高速互联,通常用8卡高功耗机型,配足内存与高速存储,网络优先InfiniBand,适合大模型预训练、微调和长时间批量作业。推理场景更看重单卡显存能否装下模型、并发响应和能效比,机型可以更灵活,4卡甚至2卡也能跑,存储和网络压力相对小,但对稳定性、散热和电费更敏感。
采购前先把业务想清楚:是训练还是推理,是在线还是离线,模型规模大概多大,峰值并发多少。如果是既有训练又有推理的混合场景,可以考虑按主力用途定平台,把次要任务放到后续扩容的节点上。把这些说清楚,卡数、显存和整机平台的选择自然就有了方向,也能避免为用不到的性能买单。
六、散热与供电:4U八卡机型的硬性条件
高功耗加速卡集中在4U机箱里,散热和供电是整机方案里最容易被低估的环节。8卡机型满配时整机功耗可能达到数千瓦,机箱需要分区风道和大尺寸风扇来保证进风量,机房也要留出足够的制冷余量。供电上要选冗余电源,按整机峰值功耗留出冗余比例,避免满载时掉电或触发保护,引起训练中断。
部署前建议核算机柜的供电容量和制冷能力,如果单个机柜承载有限,可以考虑液冷机型或分散部署。曙光AI机型在风道设计和电源冗余上有成熟方案,能降低长时间满载运行的风险,但前提是按实际功耗做规划,不能想当然。机房进风温度、机柜前后留空和线缆走线同样会影响散热效果,这些细节在部署阶段就要一并考虑。
七、曙光AI服务器的价格区间与采购思路
这类AI服务器的价格跨度很大,主要取决于加速卡型号和数量、CPU与内存规格、存储容量和网络配置。入门级推理或小规模训练机型,通常是单卡到双卡配置,价格相对可控,适合预算有限的团队先跑通业务;主流的4到8卡训练机型,随着卡数和显存提升,整机价格会成倍增长,这也是AI服务器预算的大头。
需要提醒的是,显卡价格受供货和行情波动影响明显,同款机型不同时期的报价可能相差不小,采购前最好拿到当期实价再做预算,不要用几个月前的报价来定方案。预算有限时,可以先买一台单机做验证,后续再按需扩容,把钱花在真正影响业务的地方。明确的配置清单和当期报价,是控制预算、避免踩坑的前提。
八、公司服务承诺与采购建议
北京今朝恒业成立于2001年,深耕服务器整机与配件领域20多年,累计服务300+企业客户。公司提供中科曙光服务器等品牌的原厂授权渠道,整机与配件均可1台起订、按大客户价供应,支持对公合同和增值税专票,原厂质保序列号可验。公司位于北京海淀,常规现货机型24小时内发货,工作时间内最快1小时报价。
无论是先拿一台做验证,还是批量搭建算力集群,都可以先说明模型规模、并发量和预算,我们再帮你把曙光AI服务器的配置清单落到具体型号上,让选型既有依据,也好落地。
延伸阅读:中科曙光服务器怎么样?主流机型与选购指南、GPU服务器报价与成本分析:8卡A100/H100服务器到底多少钱?2026年采购预算指南、H200和B200有什么区别?AI服务器GPU怎么选。
常见问题
曙光AI服务器支持什么GPU?
主流机型支持NVIDIA A系列/H系列全高全长卡,也已完成多款国产GPU适配;选卡先看显存容量和卡间互联需求,多卡训练优先选支持NVLink或高速互联的机型。
跑大模型需要几台GPU服务器?
7B/13B模型推理1台单机8卡就富余;70B推理建议2台8卡起步;从零训练百亿级以上模型才需要按集群规划。多数企业场景是1台8卡机先跑起来再扩。
曙光AI服务器和超微、戴尔比怎么选?
曙光为原厂授权渠道且国产化适配能力强,政务信创项目优势明显;对英伟达软件栈和海外生态兼容要求高的场景,可对比超微、戴尔机型,按软件栈与售后属地决定。